easyExcel本身支持简单的单元格合并,一共有两种合并策略:
- 一次性的合并策略(OnceAbsoluteMergeStrategy)
- 循环的合并策略(LoopMergeStrategy)
   /**
     * 合并单元格
     * <p>
     * 1. 创建excel对应的实体对象 参照{@link DemoData} {@link DemoMergeData}
     * <p>
     * 2. 创建一个merge策略 并注册
     * <p>
     * 3. 直接写即可
     *
     * @since 2.2.0-beta1
     */
    @Test
    public void mergeWrite() {
        // 方法1 注解
        String fileName = TestFileUtil.getPath() + "mergeWrite" + System.currentTimeMillis() + ".xlsx";
        // 在DemoStyleData里面加上ContentLoopMerge注解
        // 这里 需要指定写用哪个class去写,然后写到第一个sheet,名字为模板 然后文件流会自动关闭
        EasyExcel.write(fileName, DemoMergeData.class).sheet("模板").doWrite(data());

        // 方法2 自定义合并单元格策略
        fileName = TestFileUtil.getPath() + "mergeWrite" + System.currentTimeMillis() + ".xlsx";
        // 每隔2行会合并 把eachColumn 设置成 3 也就是我们数据的长度,所以就第一列会合并。当然其他合并策略也可以自己写
        LoopMergeStrategy loopMergeStrategy = new LoopMergeStrategy(2, 0);
        // 这里 需要指定写用哪个class去写,然后写到第一个sheet,名字为模板 然后文件流会自动关闭
        EasyExcel.write(fileName, DemoData.class).registerWriteHandler(loopMergeStrategy).sheet("模板").doWrite(data());
    }
但是往往实际应用中,我们并不能立马指定合并的单元格,就比如我这次需要根据订单id相同的合并单元格,但是数据还没查询出来时,我是不知道哪些要合并的,而我只知道两个要求:
- 订单id相同的单元格需要合并,
- 前七列的单元格需要合并,后面的不需要。
好了既然,easyExcel原有的不能满足我的要求,那我们可以自己写一个嘛。
先引入excel依赖
<dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>easyexcel</artifactId>
    <version>3.2.1</version>
</dependency>
首先我们可以发现EasyExcel有一个抽象类AbstractMergeStrategy,这不是摆明要我们去实现它嘛,就它了!
/**
 * Merge strategy
 *
 * @author Jiaju Zhuang
 */
public abstract class AbstractMergeStrategy implements CellWriteHandler {

    /**
    *单元格创建之前
    */
    @Override
    public void beforeCellCreate(WriteSheetHolder writeSheetHolder, WriteTableHolder writeTableHolder, Row row,
        Head head, Integer columnIndex, Integer relativeRowIndex, Boolean isHead) {

    }

    /**
    *单元格创建之后
    */
    @Override
    public void afterCellCreate(WriteSheetHolder writeSheetHolder, WriteTableHolder writeTableHolder, Cell cell,
        Head head, Integer relativeRowIndex, Boolean isHead) {}

     /**
      *单元数据转换后
      */
    @Override
    public void afterCellDataConverted(WriteSheetHolder writeSheetHolder,
        WriteTableHolder writeTableHolder, CellData cellData, Cell cell, Head head, Integer relativeRowIndex,
        Boolean isHead) {

    }

   /**
     *单元处理后
     */
    @Override
    public void afterCellDispose(WriteSheetHolder writeSheetHolder, WriteTableHolder writeTableHolder,
        List<CellData> cellDataList, Cell cell, Head head, Integer relativeRowIndex, Boolean isHead) {
        if (isHead) {
            return;
        }
        merge(writeSheetHolder.getSheet(), cell, head, relativeRowIndex);
    }

    /**
     * merge 合并方法
     *
     * @param sheet
     * @param cell
     * @param head
     * @param relativeRowIndex
     */
    protected abstract void merge(Sheet sheet, Cell cell, Head head, Integer relativeRowIndex);
}

// 上面的方法作用我也是看方法名猜测的,具体作用稍后再试
在写之前,我看了下作者写的两个合并方法,看看他是怎么写合并的
if (isHead) {
            return;
        }
        if (relativeRowIndex % eachRow == 0) {
            CellRangeAddress cellRangeAddress = new CellRangeAddress(row.getRowNum(), row.getRowNum() + eachRow - 1,
                columnIndex, columnIndex + columnExtend - 1);
            writeSheetHolder.getSheet().addMergedRegionUnsafe(cellRangeAddress);
        }
关键看CellRangeAddress 单元格范围地址对象,他的构造方法允许传入四个参数,分别对应要合并的单元格的四个角的点的坐标(单元格的首行数,单元格的尾行数,单元格的首列数,单元格的尾列数),意思就是确定要合并单元格的地址,交给writeSheetHolder去合并。
现在知道如何合并单元格了,接下来就是计算需要合并的单元格的位置了
- 将查询出来的的列表数据,存入list集合,循环遍历,计算订单id相同的首行数和下行的行数,这样我们就知道哪几行需要合并了
- 再利用自定义注解,标明需要合并的列,计算单元格的首列数,尾列数
自定义合并策略
package com.lcxx.lucky.store.common.easyexcel;

import cn.hutool.core.collection.CollectionUtil;
import com.alibaba.excel.enums.CellDataTypeEnum;
import com.alibaba.excel.metadata.CellData;
import com.alibaba.excel.metadata.Head;
import com.alibaba.excel.write.merge.AbstractMergeStrategy;

import com.alibaba.excel.write.metadata.holder.WriteSheetHolder;
import com.alibaba.excel.write.metadata.holder.WriteTableHolder;
import com.lcxx.lucky.store.common.exception.impl.CommonException;
import com.lcxx.lucky.store.common.exception.impl.CommonExceptionEnum;
import lombok.SneakyThrows;
import lombok.extern.slf4j.Slf4j;
import org.apache.commons.lang.StringUtils;
import org.apache.poi.ss.usermodel.Cell;
import org.apache.poi.ss.usermodel.Row;
import org.apache.poi.ss.usermodel.Sheet;
import org.apache.poi.ss.util.CellRangeAddress;

import java.lang.reflect.Field;
import java.lang.reflect.InvocationTargetException;
import java.lang.reflect.Method;
import java.util.*;
import java.util.stream.Collectors;

/**
 * @title: MyMergeStrategy
 * @Author ggball
 * @Date: 2021/9/27 21:09
 * @Version 1.0
 */
@Slf4j
public class MyMergeStrategy<T> extends AbstractMergeStrategy {
    private int firstRowIndex;
    private int lastRowIndex;
    private int firstColumnIndex;
    private int lastColumnIndex;

    // 主键值集合
    private List<String> primaryIdList = new ArrayList<>();
    // 需要合并的列index
    Set<Integer> colIndexSet = new HashSet<>();

    public MyMergeStrategy(int firstRowIndex, int lastRowIndex, int firstColumnIndex, int lastColumnIndex) {
        if (firstRowIndex >= 0 && lastRowIndex >= 0 && firstColumnIndex >= 0 && lastColumnIndex >= 0) {
            this.firstRowIndex = firstRowIndex;
            this.lastRowIndex = lastRowIndex;
            this.firstColumnIndex = firstColumnIndex;
            this.lastColumnIndex = lastColumnIndex;
        } else {
            throw new IllegalArgumentException("All parameters must be greater than 0");
        }

    }

    /**
    *从数据list
    */
    public MyMergeStrategy(List<T> data) throws CommonException, IllegalAccessException {
        if (data.size() == 0){
            throw new CommonException(CommonExceptionEnum.HAS_NO_DATA);
        }
        for (T row : data) {
            Class<?> type = row.getClass();
            Field[] fields = getAllDeclaredFields(type);


            for (Field field : fields) {
                ExcelKey key = field.getDeclaredAnnotation(ExcelKey.class);
                if (null != key && field.getName().equals(key.value()) ) {
                    field.setAccessible(true);
                    Object filedValue = field.get(row);
                    field.setAccessible(false);
                    if (null != filedValue) {
                        // 添加合并主键值
                        primaryIdList.add(String.valueOf(filedValue));
                    }
                    break;
                }
            }

        }

        // 获取需要合并的列
        T row = data.get(0);
        Class<?> aClass = row.getClass();
        Field[] fields = getAllDeclaredFields(aClass);
        for (int i = 0; i < fields.length; i++) {
            Field field = fields[i];
            ExcelMerge merge = field.getDeclaredAnnotation(ExcelMerge.class);
            if (null != merge && merge.isMerge()) {
                colIndexSet.add(i);
            }
        }


    }


    /**
     * 获取合并的首行坐标和下行行数
     * @return map<合并的首行坐标,下行行数>
     */
    public Map<Integer,Integer> getMergeRowMap() {
        Map<Integer, Integer> mergeRowMap = new HashMap<>();
        if (CollectionUtil.isEmpty(primaryIdList)) {
            return mergeRowMap;
        }
        // 主键索引
        int idIndex = 0;
        // 主键临时值
        String tempValue = null;

        // 如果主键都相同
        HashSet<String> idSet = new HashSet<>(primaryIdList);
        if (idSet.size() == 1) {
            mergeRowMap.put(0,primaryIdList.size()-1);
            return mergeRowMap;
        }

        // 主键不相同
        for (int i = 0; i < primaryIdList.size(); i++) {
            if (null == tempValue) {
                tempValue = primaryIdList.get(i);
            }
            String id = primaryIdList.get(i);
            if (!id.equals(tempValue)) {
                mergeRowMap.put(idIndex,(i-1)-idIndex);
                idIndex = i;
                tempValue = null;
            }
            if (primaryIdList.size()-1 == i) {
                mergeRowMap.put(idIndex,i-idIndex);
            }


        }

        return mergeRowMap;
    }

    /**
    *获取类的属性和方法
    */
    public static Field[] getAllDeclaredFields(Class<?> clazz) {
        Class<?> superclass;
        List<Field> fieldList = new ArrayList<>(Arrays.asList(clazz.getDeclaredFields()));
        while ((superclass = clazz.getSuperclass()) != null) {
            fieldList.addAll(new ArrayList<>(Arrays.asList(superclass.getDeclaredFields())));
            clazz = superclass;
        }
        Field[] res = new Field[fieldList.size()];
        res = fieldList.toArray(res);
        return res;
    }


    /**
    *合并单元格方法
    */
    protected void merge(Sheet sheet, Cell cell, Head head, Integer relativeRowIndex) {
        Map<Integer, Integer> mergeRowMap = getMergeRowMap();
        // 行坐标
        int rowIndex = cell.getRowIndex();
        // 列坐标
        int columnIndex = cell.getColumnIndex();
        // 下行行数
        Integer downRows = mergeRowMap.get(rowIndex-head.getHeadNameList().size());

        // 和并列坐标
        boolean mergeContains = colIndexSet.contains(columnIndex);
        if (null != downRows && mergeContains) {

            // 创建单元格范围地址
            CellRangeAddress cellRangeAddress = new CellRangeAddress(rowIndex, rowIndex+downRows, columnIndex, columnIndex);
            sheet.addMergedRegionUnsafe(cellRangeAddress);
        }

    }

    @Override
    public void afterCellDataConverted(WriteSheetHolder writeSheetHolder, WriteTableHolder writeTableHolder, CellData cellData, Cell cell, Head head, Integer relativeRowIndex, Boolean isHead) {

        // 如果字符类型的单元格值为空字符串,那就设置成“/”
        if (cellData.getType().equals(CellDataTypeEnum.STRING) && StringUtils.isBlank(cellData.getStringValue())) {
            cellData.setStringValue("/");
        }

        // 如果数字类型的单元格值为空,那就设置成“/”
        if (cellData.getType().equals(CellDataTypeEnum.NUMBER) && null == cellData.getNumberValue()) {
            cellData.setStringValue("/");
        }

        super.afterCellDataConverted(writeSheetHolder, writeTableHolder, cellData, cell, head, relativeRowIndex, isHead);
    }

}
上面计算订单id相同的首行数和下行的行数,如果大家有不一样的方法,欢迎大家提出想法
合并主键注解
@Target({ElementType.FIELD, ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
public @interface ExcelKey {
    String value() default "";
}
合并列注解
@Target({ElementType.FIELD, ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
public @interface ExcelMerge {
    boolean isMerge() default true;
}
excel导出VO
@Data
public class AfterSaleExcelListVo implements Serializable {

    /**
     * 售后订单编号
     */
    @ExcelProperty(value = {"销售售后单/铺货售后单导出","售后订单编号"})
    @ExcelKey("saleBillId")
    @ExcelMerge
    private String saleBillId;

    /**
     * 售后类型 1=退货退款,2=仅退款,3=补寄
     */
    @ExcelProperty(value = {"销售售后单/铺货售后单导出","售后类型"},converter = SaleTypeConverter.class)
    @ExcelMerge
    private Integer saleType;

    ****

    }
easyExcel添加策略
        // 这里注意 有同学反应使用swagger 会导致各种问题,请直接用浏览器或者用postman
        response.setContentType("application/vnd.openxmlformats-officedocument.spreadsheetml.sheet");
        response.setCharacterEncoding("utf-8");
        // 这里URLEncoder.encode可以防止中文乱码 当然和easyexcel没有关系
        String fileName = URLEncoder.encode(filename, "UTF-8").replaceAll("\\+", "%20");
        response.setHeader("Content-disposition", "attachment;filename*=utf-8''" + fileName + ".xlsx");
        EasyExcel.write(response.getOutputStream(), clazz)
                .sheet("sheet1")
                .registerWriteHandler(new LongestMatchColumnWidthStyleStrategy())//设置导出单元格宽度自适应
                .registerWriteHandler(new OnceMergeStrategy(data)) // 设置合并策略
                .registerWriteHandler(setSheetStyle())
                .doWrite(data);
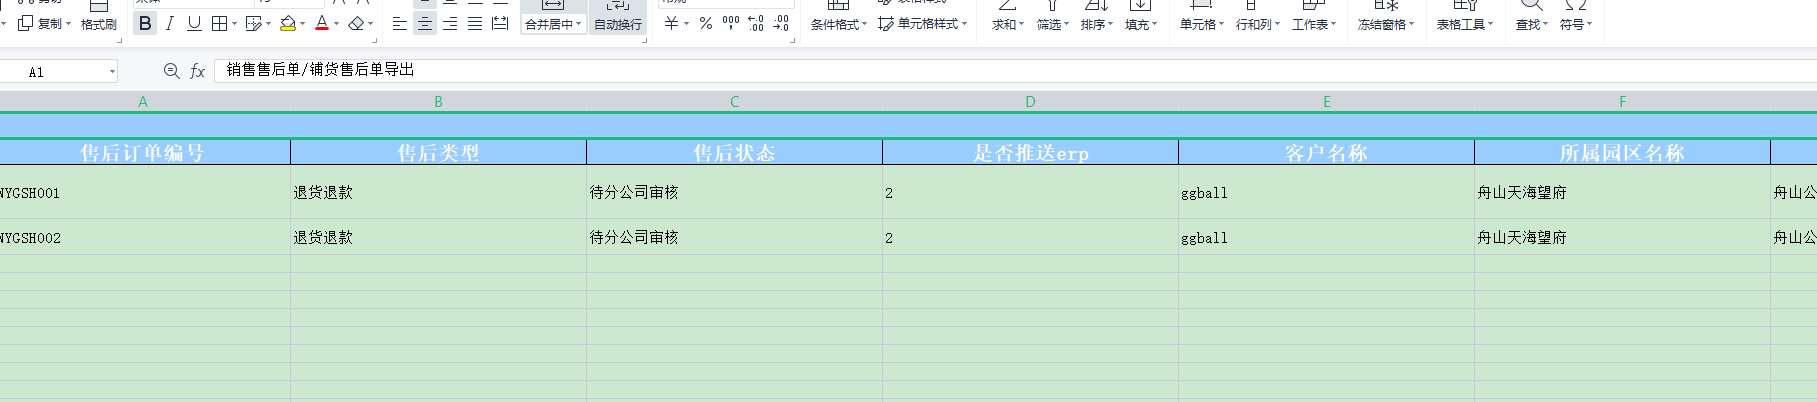
效果图
总结:活不多,要勤于思考!